2026年1月27日、DeepSeekは包括的な研究論文とともに、DeepSeek-OCR 2をHuggingFaceとGitHubで公開しました。
この新モデルは、ドキュメント処理における大きなブレークスルーです。固定されたスキャンパターンに従うのではなく、コンテンツに基づいてモデルが視覚トークンを動的に並べ替えられる技術、Visual Causal Flowを導入しています。視覚圧縮に重点を置いていた初代DeepSeek-OCRとは異なり、OCR 2は、モデルが人間により近い方法でドキュメントを理解し処理できるようにする、別のアプローチを採用しています。
このリリースは、精度、読み取り順序の理解、本番環境での信頼性において大幅な改善を示しており、大きな注目を集めています。
1. OCRとは:定義と従来の限界
光学文字認識(OCR)技術は、テキスト画像を機械が読めるテキストへ変換します。従来のOCRシステムや初期の視覚言語モデル(VLM)は、画像を左から右、上から下へ読む固定的なラスタースキャン処理に依存しており、これは人間が視覚情報を自然に知覚する方法と矛盾します。この機械的なアプローチは何十年にもわたり標準とされてきましたが、意味理解とは根本的に整合していません。
固定的なラスタースキャン順序は、複雑なドキュメントレイアウトを処理する際に深刻な問題を生みます。VLMが複数列の表に遭遇すると、ヘッダー行を処理し、その後に列2の行1、列2の行2へ移り、最後に列1の各行へ戻るため、非論理的なトークン列が生成されます。同様に、複数列のテキスト、説明文の中に挿入された数式、混在するコンテンツタイプも不自然な順序で読まれ、モデルが情報間の関係を誤解する原因になります。
これにより、3つの重大な失敗が発生します。複雑なドキュメントでの精度低下、関連情報がシーケンス全体に分散してしまうことによる読み取り順序解釈の誤り、そしてテキストの重複やハルシネーションを含む本番環境でのエラー率上昇です。根本的な問題は、従来のVLMが情報の意味的な流れを理解していないことです。単に機械的なスキャンパターンに従っているだけなのです。
2. DeepSeek-OCR 2のソリューション
Visual Causal Flow:中核となるイノベーション
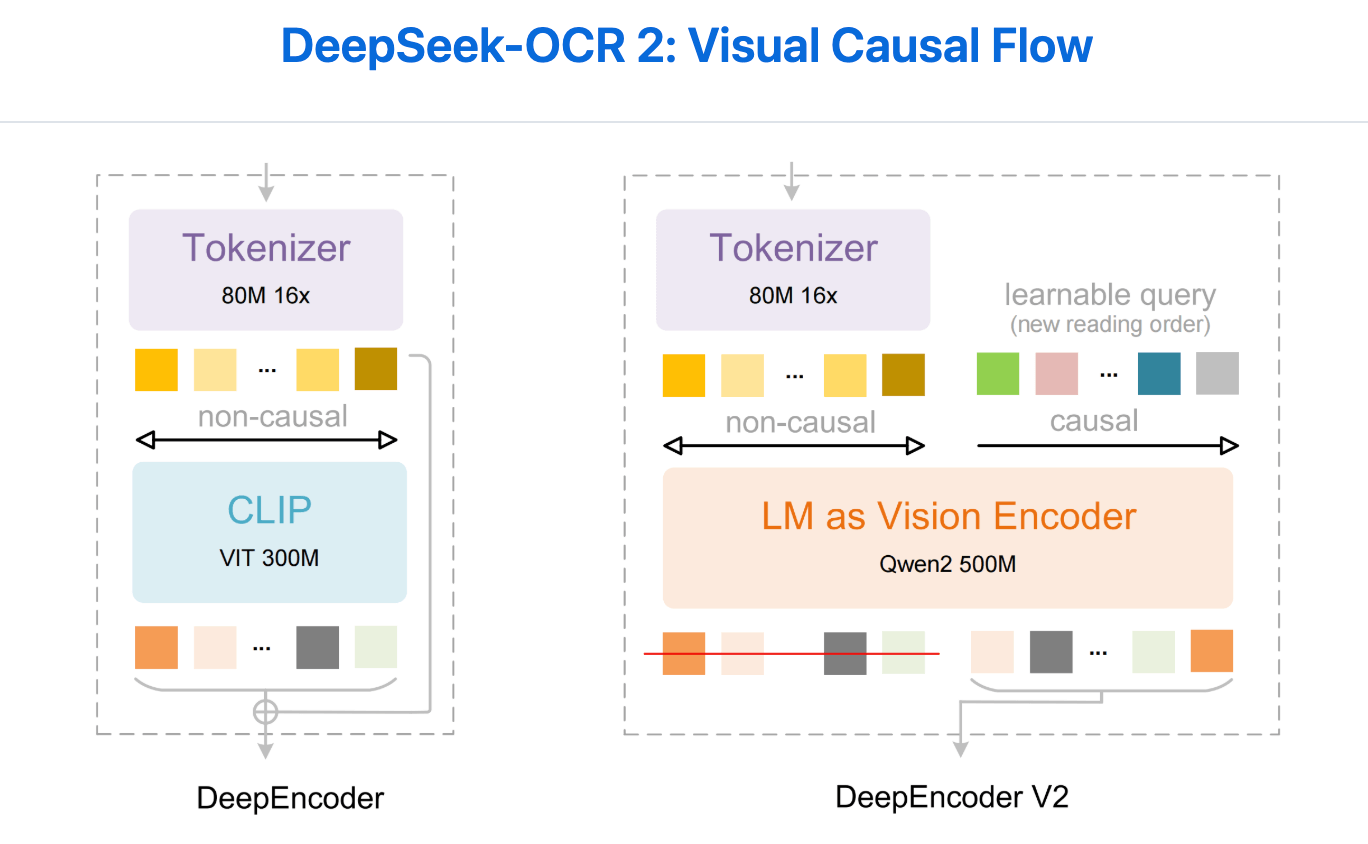
DeepSeek-OCR 2は、Visual Causal Flowと呼ばれる革新的な概念を導入しています。これは、画像コンテンツと意味的関係に基づいて視覚トークンを動的に並べ替える能力をモデルに与えるものです。固定的なラスタースキャンパターンに従うのではなく、モデルはドキュメント内の情報の論理的な流れを理解し、その論理的な順序に合うよう視覚トークンを再編成します。これは従来のアプローチとは根本的に異なります。単なる圧縮性能の向上や、より賢い特徴抽出ではなく、言語モデルに対して視覚情報をどのように順序付けるべきかを全面的に再構想するものです。
重要な洞察は、視覚理解は因果的であるべきだという点です。モデルは、複雑なドキュメント内で人間が情報の流れをたどるのと同じように、どの視覚要素が他の要素に論理的に先行するかを推論すべきです。表を読むとき、人間は機械的に左から右へスキャンするのではありません。ヘッダー行が文脈を提供していることを理解し、そのうえで各列のデータを順番に読みます。DeepSeek-OCR 2はこの推論プロセスを再現します。
DeepEncoder V2は、4つの主要なイノベーションによってVisual Causal Flowを支えています:
イノベーション1:コンパクトなLLMバックボーン
初代DeepEncoderは、視覚エンコーディングのバックボーンとしてCLIPを使用していました。DeepSeek-OCR 2は、CLIPをコンパクトなLLMアーキテクチャであるQwen2-0.5Bに置き換えています。これにより、エンコーダーは言語理解能力を活用し、視覚コンテンツを意味的に推論できるようになります。視覚エンコーダーとして言語モデルを使用することで、視覚的特徴だけでなく、視覚要素間の意味的関係も理解できます。Qwen2-0.5Bは、意味理解能力と計算効率のバランスを取っています。
イノベーション2:ハイブリッドアテンション機構
このアーキテクチャは、2つの構成要素を持つアテンションを使用します。視覚トークンには双方向アテンション(ViTスタイル)を使用し、各トークンが方向の制約なしに他のすべてのトークンへ注意を向けられるようにします。これにより、画像全体の文脈と離れた関係性を捉えます。同時に、学習可能なクエリトークンが因果フロークエリを扱い、すべての視覚トークンと過去のクエリに注意を向けて、論理的な並べ替えを実行します。双方向アテンションは文脈理解を担い、因果アテンションは論理的な順序付けを担います。
イノベーション3:カスケード型因果推論
2段階のカスケード構造は、視覚情報の流れ方を変えます。エンコーダーはクエリトークンを使って意味的な並べ替えを行い、ドキュメントコンテンツの流れを尊重した順序付きシーケンスを作成します。その後、LLMデコーダーがこの知的に並べられたシーケンスを処理します。両段階は連携して機能し、デコーダーは読み取り順序を見つけ出すことではなく、コンテンツ理解に集中できるため、効率と精度が向上します。
イノベーション4:インテリジェントなトークン圧縮
視覚トークンは、画像の複雑さに応じて256-1,120の範囲に制御されます。これにより、Gemini 3 Proのようなモデルのトークン予算内に収まりながら、高い圧縮率を維持できます。トークンは知的に並べ替えられ、意味的に優先順位付けされるため、圧縮によって品質が犠牲になることはありません。表のヘッダーには装飾要素より多くのトークンが割り当てられ、テキストの多い領域には余白より多くのトークンが割り当てられます。
性能改善
これらのイノベーションは測定可能な改善をもたらしています。OmniDocBench v1.5で91.09%の精度(初代比+3.73%)、読み取り順序の編集距離は0.085から0.057へ低下(32.9%改善)、本番環境での重複率は6.25%から4.17%へ低下(33.3%削減)、最大1,120の視覚トークンにより、より高速な推論と優れたスケーラビリティを実現しています。
3. 影響と今後のトレンド
現在の影響と業界での応用
DeepSeek-OCR 2は、複数の業界にわたるドキュメント理解の新たな標準を打ち立てています。金融機関は、複雑な財務諸表、請求書、契約書を大幅に高い精度で処理できるようになります。法律事務所は、正しい読み取り順序を維持しながら複数ページのドキュメントから情報を抽出できます。学術機関は、数式や図の認識が改善された状態で研究論文を分析できます。Eコマース企業は、多様なドキュメント形式から製品情報をより信頼性高く抽出できます。
オープンソースでの公開により、最先端のOCR技術へのアクセスが民主化され、スタートアップや小規模組織でも大規模なR&D投資なしに高度なドキュメント処理パイプラインを構築できるようになります。これは世界中のデジタルトランスフォーメーション施策に大きな意味を持ちます。
今後の方向性と研究上の示唆
DeepSeekは、今後の開発に向けた意欲的な計画を示しています。同チームは、2つの1D因果推論器を使用するカスケード型アプローチを通じて、真の2D画像理解と推論の実装を探る予定です。この進化により、水平・垂直の同時推論を必要とする空間的関係や複雑な視覚レイアウトを理解するモデルの能力がさらに高まります。
OCRを超えて、Visual Causal Flowの概念は視覚言語モデルにより広範な示唆をもたらします。意味コンテンツに基づいて視覚トークンを動的に並べ替えるという原理は、他のVLMタスクにも適用でき、ドキュメント理解、視覚質問応答、画像キャプション生成などで性能を向上させる可能性があります。これは、VLMが視覚情報を処理する方法におけるパラダイムシフトを表しています。固定的なスキャンパターンから、知的でコンテンツを認識した順序付けへ移行するものです。
Document AIにおける新たなトレンド
Visual Causal Flowの成功は、より広範なAIコミュニティで同様のアプローチを促す可能性が高いでしょう。意味を考慮したトークン順序付け、階層的なドキュメント理解、文脈認識型の視覚処理に関する研究が増えると予想されます。言語モデルと視覚理解の組み合わせはますます高度化しており、DeepSeek-OCR 2は、トークン順序付けにおけるアーキテクチャ上のイノベーションが大きな性能向上を生み出せることを示しています。
Ihr KI-Rezeptionist ist in Minuten live.
Skalieren Sie Ihren Empfang mit einer KI, die nie schläft. Solvea bearbeitet unbegrenzte Anfragen über mehrere Kanäle, bucht Termine automatisch in Ihren Kalender und verhindert rund um die Uhr verpasste Chancen.
4. 結論
DeepSeek-OCR 2は、機械が視覚情報を理解する方法における根本的なパラダイムシフトを表しています。Visual Causal Flowと革新的なDeepEncoder V2アーキテクチャを導入することで、このモデルは何十年も残り続けてきた従来型アプローチの中核的な限界に対処します。優れた精度(91.09%)、改善された読み取り順序理解(32.9%向上)、強化された本番環境での信頼性(重複33.3%削減)、卓越した効率性(最大1,120トークン)の組み合わせにより、ドキュメント処理に変革をもたらすソリューションとなっています。
コンパクトなLLMバックボーン、ハイブリッドアテンション機構、カスケード型推論、インテリジェントな圧縮というアーキテクチャ上のイノベーションが連携し、モデルが機械的なスキャンパターンに従うのではなく、意味的な流れを理解しながら、人間と同じようにドキュメントを処理できるようにしています。HuggingFaceとGitHubでオープンソースとして利用できるため、これらの進歩は世界中のコミュニティがすぐに活用できます。DeepSeek-OCR 2は、従来のOCRシステムに対する単なる漸進的な改善ではありません。機械が人間のような意味認識をもって視覚情報を推論できる、ドキュメント理解の新時代を示しています。